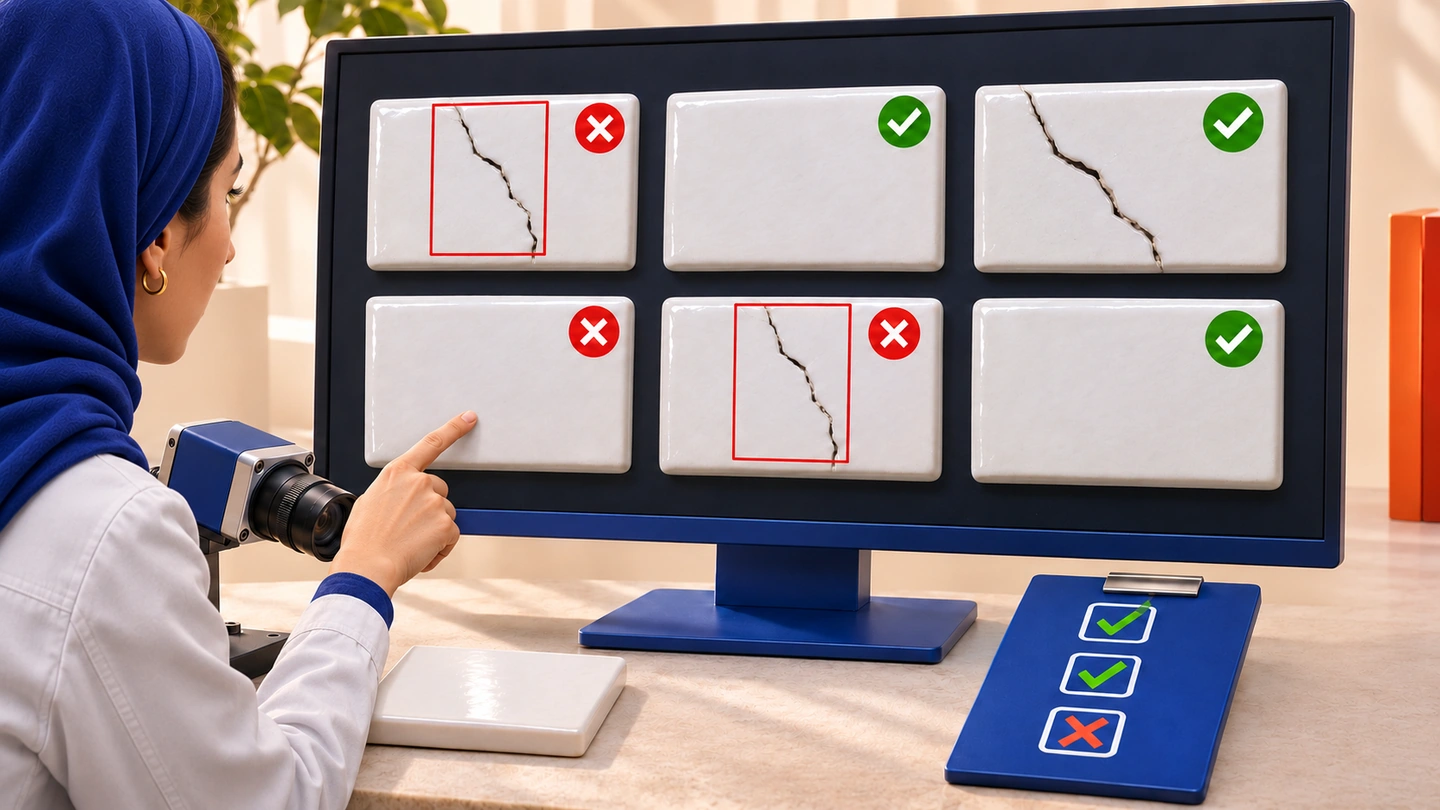
برای سنجش دقت مدل بینایی ماشین، باید پیشبینیها را با نتیجهٔ مرجع مقایسه کنید و دو خطا را جدا بشمارید: مواردی که مدل جا انداخته و هشدارهایی که اشتباه بودهاند. Precision سهم هشدارهای درست را نشان میدهد و Recall سهم موارد مهمی را که پیدا شدهاند. این عددها وقتی قابل استفادهاند که دادهٔ آزمون، شرایط اجرا و آستانهٔ تصمیمگیری هم مشخص باشند.
در کنترل کیفیت، عبور یک قطعهٔ معیوب با توقف بیدلیلِ یک قطعهٔ سالم پیامد یکسانی ندارد. گزارش «دقت ۹۵ درصد» بهتنهایی روشن نمیکند کدام خطا رخ داده است. با یک مثال عددی میتوان دید چه اطلاعاتی باید از گزارش ارزیابی بخواهید.
اول مشخص کنید چه چیزی را ارزیابی میکنید
تشخیص سالم یا معیوب بودن کل عکس، پیدا کردن یک شیء با کادر و مشخص کردن مرز آسیب، خروجیهای متفاوتی هستند. برای هرکدام معیار مناسب لازم است. در مثال اصلی این مقاله، هر تصویر فقط یک قطعه دارد و مدل باید آن را «سالم» یا «معیوب» اعلام کند؛ در ادامه، تفاوت ارزیابی کادرها را هم بررسی میکنیم.
اگر با این خروجیها آشنا نیستید، مقالهٔ بینایی ماشین چیست و چه کاربردهایی دارد؟ نقطهٔ شروع مناسبی است. برای ارزیابی، تعریف «عیب» نیز باید از قبل روشن باشد تا کارشناس و مدل بر اساس یک قاعده مقایسه شوند.
چرا Accuracy بهتنهایی کافی نیست؟
Accuracy نسبت پاسخهای درست به کل نمونههاست. فرض کنید از هزار تصویر، فقط ده تصویر قطعهٔ معیوب داشته باشند. مدلی که همه را سالم اعلام کند، ۹۹ درصد پاسخ درست دارد؛ درحالیکه هیچ عیبی را پیدا نکرده است. وقتی تعداد دستهها نامتوازن است، این شاخص میتواند ضعف مدل در دستهٔ کمتعداد را پنهان کند.
پس همراه با درصد کلی، تعداد نمونهٔ هر دسته و نوع اشتباهها را ببینید. عبارت «۹۹ درصد دقت» باید با نام معیار، مجموعهٔ آزمون و روش محاسبه همراه باشد.
چهار نتیجه در ماتریس درهمریختگی
در اینجا کلاس مثبت را «قطعهٔ معیوب» در نظر میگیریم. «مثبت» اصطلاح فنی است و به معنی خوب یا مطلوب بودن نتیجه نیست. مقایسهٔ پیشبینی با نظر مرجع چهار حالت دارد:
| نتیجه | واقعیت | پیشبینی مدل |
|---|---|---|
| TP؛ مثبت درست | قطعه معیوب است | معیوب اعلام شده |
| FP؛ مثبت کاذب | قطعه سالم است | معیوب اعلام شده؛ هشدار اشتباه |
| FN؛ منفی کاذب | قطعه معیوب است | سالم اعلام شده؛ عیب جاافتاده |
| TN؛ منفی درست | قطعه سالم است | سالم اعلام شده |
ماتریس درهمریختگی همین مقایسه را در قالب جدول نشان میدهد. عنوان سطر و ستون را بخوانید؛ بعضی ابزارها واقعیت را در سطر و بعضی در ستون قرار میدهند. بدون توجه به این عنوانها، ممکن است FP و FN را جابهجا تفسیر کنید.
Precision و Recall چه تفاوتی دارند؟
Precision میپرسد از همهٔ مواردی که مدل معیوب اعلام کرده، چند مورد واقعاً معیوب بودهاند. مخرج این نسبت، تمام هشدارهای مدل است:
Precision = TP / (TP + FP)
Recall میپرسد از تمام قطعات واقعاً معیوب، چند مورد پیدا شدهاند. مخرج این نسبت، تمام عیبهای موجود در دادهٔ آزمون است:
Recall = TP / (TP + FN)
Precision بالا به معنی جا نیفتادن عیبها نیست؛ مدل شاید فقط چند مورد آسان را اعلام کرده باشد. Recall بالا هم باید کنار هشدارهای اشتباه بررسی شود. اگر مدل همهٔ قطعات را معیوب اعلام کند، همهٔ عیبها را پیدا میکند، اما محصولات سالم هم برای بازبینی فرستاده میشوند.
مثال عددی با ۱۰۰ تصویر قطعه
در یک مثال فرضی، مجموعهٔ آزمون ۲۰ تصویر معیوب و ۸۰ تصویر سالم دارد. مدل ۱۸ تصویر را معیوب اعلام میکند؛ ۱۵ مورد درست و ۳ مورد اشتباهاند. همچنین ۵ تصویر معیوب را سالم تشخیص داده و ۷۷ تصویر سالم را درست کنار گذاشته است.
| واقعیت / پیشبینی | معیوب اعلام شده | سالم اعلام شده |
|---|---|---|
| واقعاً معیوب | ۱۵؛ TP | ۵؛ FN |
| واقعاً سالم | ۳؛ FP | ۷۷؛ TN |
- Precision: از ۱۸ هشدار، ۱۵ مورد درست است؛ حدود ۸۳٫۳ درصد.
- Recall: از ۲۰ عیب واقعی، ۱۵ مورد پیدا شده؛ ۷۵ درصد.
- Accuracy: مجموع پاسخهای درست ۹۲ مورد از ۱۰۰ مورد است؛ ۹۲ درصد.
با وجود Accuracy برابر ۹۲ درصد، یکچهارم عیبها جا افتادهاند. گزارش تعدادها این موضوع را سریعتر از یک درصد کلی نشان میدهد.
«سهم هشدارهای اشتباه از همهٔ هشدارها» با «نرخ هشدار اشتباه در قطعات سالم» تفاوت دارد. در همین مثال، نسبت اول ۳ از ۱۸، یعنی حدود ۱۶٫۷ درصد است؛ نسبت دوم ۳ از ۸۰، یعنی ۳٫۷۵ درصد. برای گزارش نرخ خطا، مخرج کسر را هم بنویسید.
F1-score چه چیزی را خلاصه میکند؟
F1 میانگین هارمونیک Precision و Recall است. در مثال بالا مقدار آن حدود ۷۸٫۹ درصد میشود:
F1 = 2 × TP / (2 × TP + FP + FN)
این عدد برای مقایسهٔ خلاصه مفید است، اما هزینهٔ متفاوت عبور قطعهٔ معیوب و رد قطعهٔ سالم را مستقیم وارد محاسبه نمیکند. برای پذیرش سامانه، تعداد هر دو خطا و هزینهٔ عملیاتی آنها را هم بررسی کنید.
در گزارش چندکلاسه، میانگین میتواند ضعف یک کلاس را پنهان کند. نتیجهٔ هر کلاس و تعداد نمونههایش را جدا بخواهید. میانگین Macro به کلاسها وزن برابر میدهد؛ Weighted بر اساس تعداد نمونههای واقعی هر کلاس وزن میدهد. نام روش میانگینگیری باید کنار عدد باشد.
آستانهٔ تصمیم چگونه خطاها را تغییر میدهد؟
مدل ممکن است برای هر تصویر یک امتیاز بدهد و سامانه بر اساس آستانه، آن را معیوب اعلام کند. با ثابت ماندن امتیازها، پایین آوردن آستانه معمولاً موارد بیشتری را مثبت میکند؛ هم میتواند عیبهای بیشتری پیدا کند و هم هشدار اشتباه بیشتری بسازد. Precision در همهٔ مجموعهها الزاماً تغییر یکنواخت ندارد؛ نتیجه را باید اندازه گرفت.
چند آستانه را روی دادهٔ اعتبارسنجی مقایسه کنید و تعداد عیبهای جاافتاده، هشدارهای اشتباه و حجم کار بازبین را کنار هم بگذارید. پس از انتخاب، نسخهٔ مدل و آستانه را ثبت و آزمون نهایی را با همان تنظیمات اجرا کنید.
امتیاز ۰٫۹ برای یک تصویر، بهخودیِخود به معنی «۹۰ درصد دقت سامانه» نیست. برای تعبیر امتیاز به احتمالِ قابل اتکا، موضوع کالیبراسیون نیز باید بررسی شود. معیار ارزیابی را از نتایج مجموعهٔ آزمون به دست آورید.
برای تشخیص شیء و کادرها چه چیزی اضافه میشود؟
اگر خروجی مدل کادر است، درست بودن نام شیء کافی نیست؛ محل کادر هم باید با مرجع تطبیق داشته باشد. IoU نسبت مساحت همپوشانی دو کادر به مساحت اجتماع آنهاست. در ارزیابی باید روشن باشد چه همپوشانیای برای تطبیق پذیرفته میشود و کادرهای تکراری چگونه شمرده میشوند.
AP کیفیت تشخیص را با توجه به Precision و Recall در امتیازهای مختلف خلاصه میکند و mAP آن را روی کلاسها میانگین میگیرد. شرایط محاسبه اهمیت دارند: برای نمونه، AP در IoU برابر ۰٫۵ با معیار COCO که روی آستانههای ۰٫۵ تا ۰٫۹۵ با گام ۰٫۰۵ میانگین میگیرد، یک عدد قابل جایگزینی نیست.
مقایسهٔ دو مدل را با داده، تعریف کلاس، تنظیمات ارزیابی و سقف تعداد تشخیصِ یکسان انجام دهید. برای خروجیهایی مثل شمارش کالا، خطای شمارش هم باید جدا سنجیده شود.
چه چیزهایی نتیجهٔ ارزیابی را گمراهکننده میکنند؟
- نشت داده: عکسهای همان قطعه یا فریمهای نزدیک یک ویدئو بین آموزش و آزمون پخش شدهاند.
- مرجع نادرست: نمونههای مرزی یا برچسبهای اشتباه بدون بازبینی وارد آزمون شدهاند.
- آزمون آسان: تصاویر نور مناسب را دارد، اما شرایط دشوارِ اجرای واقعی را پوشش نمیدهد.
- تنظیم روی آزمون: تیم بعد از هر نتیجهٔ آزمون نهایی، مدل یا آستانه را تغییر میدهد.
- نمونهٔ کم: نتیجهٔ یک کلاس با چند نمونه، به شرایط متنوع تعمیم داده میشود.
روش جداسازی و بازبینی را در مقالهٔ جمعآوری و برچسبگذاری دادهٔ آموزشی بینایی ماشین توضیح دادهایم. همراه درصدها، تعداد نمونهها و وضعیتهایی را که هنوز آزموده نشدهاند ثبت کنید. نبودن نمونهٔ یک عیب، به معنی توانایی مدل در پیدا کردن آن نیست.
برای تحویل پروژه چه گزارشی بخواهیم؟
- تعریف خروجی مدل و معیار تشخیص عیب در مرجع.
- تعداد نمونهٔ هر کلاس و روش جداسازی دادهها.
- نسخهٔ مدل، آستانه و تنظیمات پیشپردازش و ارزیابی.
- ماتریس خطا، Precision و Recall هر کلاس و نمونهٔ تصویری اشتباهها.
- زمان پاسخ روی سختافزار واقعی؛ از دریافت تصویر تا رسیدن خروجی قابل استفاده.
- نتیجهٔ آزمایش در نور، سرعت و شرایط عملیاتی مورد توافق.
معیار پذیرش را پیش از اجرای آزمایشی با مسئول فرایند تعیین کنید. مثلاً تعداد عیبهای جاافتاده در یک حجم مشخص تولید و تعداد قطعات سالمِ ارجاعشده برای بازبینی باید معلوم باشد. اگر خروجی به جداکنندهٔ خط وصل است، تأخیر و درست عمل کردن کل مسیر را نیز بسنجید.
در بررسی یک پروژهٔ بینایی ماشین و هوش مصنوعی در داپا، شرح مسئله، نمونههای مجاز و هزینهٔ هر نوع اشتباه کمک میکنند معیار ارزیابی از ابتدا متناسب با کار شما انتخاب شود.
پرسشهای متداول
چه درصد دقتی برای یک پروژه قابل قبول است؟
عدد یکسانی برای همهٔ پروژهها وجود ندارد. معیار، دادهٔ آزمون، هزینهٔ خطا و شرایط کار تعیینکنندهاند. درصد را همراه تعداد خطاها و معیار پذیرش همان فرایند تفسیر کنید.
اگر مدل هیچ هشداری ندهد، Precision آن چند است؟
وقتی هیچ پیشبینی مثبت وجود ندارد، مخرج فرمول Precision صفر و مقدار آن تعریفنشده است. ابزار ممکن است طبق تنظیمات صفر، مقدار دیگری یا هشدار برگرداند؛ این وضعیت را بهعنوان عملکرد بیخطا گزارش نکنید.
آیا F1 بالا برای انتخاب مدل کافی است؟
خیر. تعداد خطاهای مهم، عملکرد هر کلاس، دادهٔ مستقل و زمان پاسخ را هم بررسی کنید. F1 هزینهٔ عملیاتی دو نوع خطا را بهتنهایی نشان نمیدهد.
آیا باید بعد از استقرار هم مدل را ارزیابی کنیم؟
بله. تغییر نور، دوربین، محصول یا سهم عیبها میتواند عملکرد را عوض کند. نمونههای تازه را طبق برنامه بازبینی کنید و تغییر نسخه یا آستانه را ثبت کنید.