پاسخ بسیاری از پرسشهای کارکنان و مشتریان در فایلهای شرکت وجود دارد؛ اما پیدا کردن همان بند درست، بین نسخههای مختلف PDF و Word زمان میبرد. چتبات سازمانی مبتنی بر اسناد میتواند سؤال را به زبان طبیعی دریافت کند، بخشهای مرتبط فایلهای مجاز را پیدا کند و پاسخ را همراه با منبع نشان دهد.
برای ساخت چنین سامانهای، باید مسیر فایل تا پاسخ مشخص باشد: متن چطور استخراج میشود، کدام نسخه وارد جستوجو میشود، کاربر اجازهٔ دیدن چه اسنادی را دارد و پاسخ چطور به منبع وصل میشود. در این راهنما، معماری RAG و مراحل پیادهسازی این مسیر را با یک مثال بررسی میکنیم.
چتبات PDF و Word چه کاری انجام میدهد؟
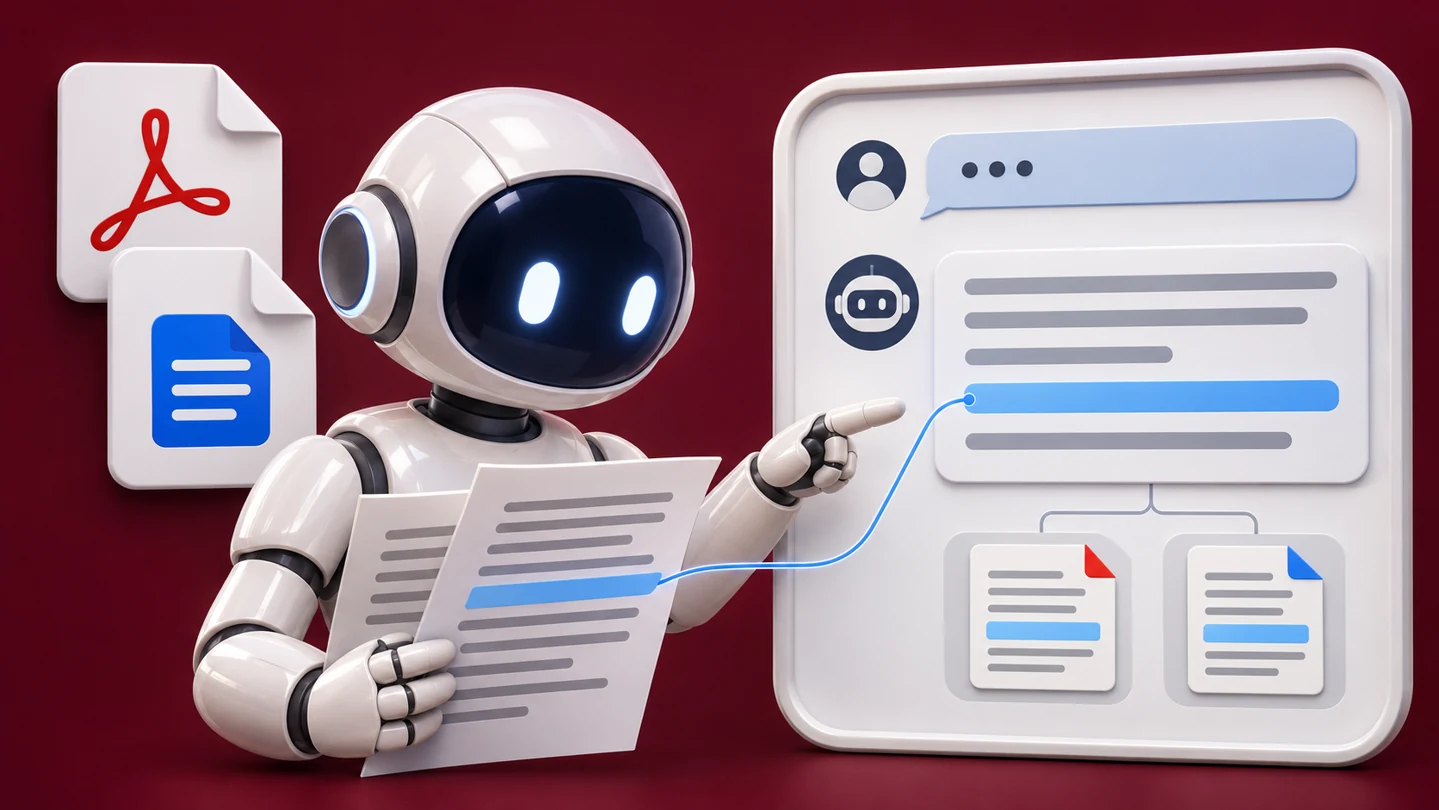
کارشناس پشتیبانی میپرسد «برای ثبت درخواست تعمیر چه مدارکی لازم است؟» سامانه در راهنماها و دستورالعملهای تعیینشده جستوجو میکند و پاسخ را با ارجاع به بند مرتبط میسازد. کاربر باید بتواند همان قسمت از سند اصلی را باز کند و توضیح را بررسی کند.
این کاربرد برای راهنمای خدمات، دستورالعملهای داخلی و پرسشهای فنی پرتکرار مناسب است. اگر سؤال به وضعیت زندهٔ سفارش یا موجودی انبار مربوط باشد، فایلها بهتنهایی کافی نیستند؛ پاسخ به اتصال مجاز به سامانهٔ اصلی هم نیاز دارد. این اتصال، بخشی جداگانه از طراحی اتوماسیون کسبوکار با هوش مصنوعی است.
معماری RAG؛ از پایگاه اسناد تا پاسخ مستند
RAG مخفف Retrieval-Augmented Generation است؛ یعنی تولید پاسخ با کمک اطلاعات بازیابیشده. در تعریف NIST، سامانهٔ بازیابی، اطلاعات مرتبط با سؤال را از پایگاه دانش پیدا میکند و در اختیار مدل مولد میگذارد. افزودن فایل به این پایگاه، بهخودیخود آموزش مجدد مدل نیست.
در یک معماری متداول، دو مسیر داریم:
- آمادهسازی دانش: دریافت فایل، استخراج متن و ساختار، تقسیم متن به بخشهای قابلجستوجو و ثبت آنها همراه مشخصات سند در نمایه.
- پاسخگویی: شناسایی کاربر، جستوجو در اسناد مجاز، انتخاب بخشهای مرتبط، تولید پاسخ و نمایش ارجاعها.
مدل زبانی، موتور جستوجو و سامانهٔ مدیریت فایل، مسئولیتهای متفاوتی دارند. مدل پاسخ را مینویسد؛ موتور جستوجو شواهد را پیدا میکند؛ مدیریت اسناد و دسترسی تعیین میکند کدام محتوا معتبر و برای چه کسی قابلمشاهده است.
مراحل پیادهسازی چتبات سازمانی با فایلهای PDF و Word
۱. محدودهٔ پاسخگویی و کاربران را مشخص کنید
برای نسخهٔ اول، یک مجموعهٔ سند و یک گروه کاربری انتخاب کنید؛ مثلاً راهنمای خدمات برای کارشناسان پشتیبانی. موضوعهای قابلپاسخ، پرسشهای خارج از محدوده و مسئول تأیید محتوا را بنویسید. چند سؤال پرتکرار واقعی، نقطهٔ شروع بهتری از فهرست طولانی امکانات هستند.
برای هر فایل، شناسه، عنوان، نسخه، تاریخ اعتبار، مالک محتوا و گروههای مجاز ثبت شود. اگر دو دستورالعمل با هم تعارض دارند، مالک سند باید نسخهٔ معتبر را مشخص کند. مدل نمیتواند از روی لحن متن، اعتبار سازمانی یک بخشنامه را تعیین کند.
۲. متن و ساختار فایلها را استخراج کنید
در PDF متنی، معمولاً متن از خود فایل استخراج میشود. در PDF اسکنشده، تشخیص متن یا OCR لازم است. کیفیت تصویر، چرخش صفحه، مهر و دستنویس میتوانند روی نتیجه اثر بگذارند. بخشی از خروجی را با اصل فایل مقایسه کنید؛ بهویژه اعداد، تاریخها و جدولها.
در Word، تیترها، فهرستها و ارتباط جدول با توضیحاتش اهمیت دارند. پشتیبانی از DOC قدیمی، DOCX و تصاویر داخل سند به ابزار استخراج وابسته است. برای نمونه، مستندات Document Intelligence مایکروسافت میان استخراج ساختار PDF و فایلهای Office تفاوتهایی بیان میکند؛ بنابراین پسوند فایل بهتنهایی تضمین استخراج کامل نیست.
برای فارسی، ترتیب خواندن متن راستبهچپ، نیمفاصله، شکلهای «ی» و «ک» و ترکیب ارقام فارسی و لاتین را بررسی کنید. خطای استخراج یک عدد، حتی با یک مدل زبانی خوب، میتواند به پاسخ نادرست منجر شود.
۳. بخشهای قابلبازیابی را همراه منبع ذخیره کنید
متن بلند به قطعههای موضوعی یا «چانک» تقسیم میشود. بهتر است عنوان بخش، توضیح ضروری و بندهای مرتبط کنار هم بمانند. جداشدن یک استثنا از قاعدهٔ اصلی یا عنوان از جدول، معنای پاسخ را تغییر میدهد.
هر قطعه باید به شناسه و نسخهٔ سند، عنوان بخش و محل دقیق آن وصل باشد. اندازهٔ مناسب قطعه را با سؤالهای همان مجموعه آزمایش کنید. یک اندازهٔ ثابت برای همهٔ راهنماها، قراردادها و جدولها نتیجهٔ یکسانی ندارد.
۴. جستوجوی واژهای و معنایی را متناسب با اسناد ترکیب کنید
برای جستوجوی معنایی، معمولاً از متن یک نمایش عددی به نام «بردار» یا Embedding ساخته میشود تا بخشهای نزدیک از نظر معنا پیدا شوند. جستوجوی واژهای هم برای نام محصول، کد فرم و شمارهٔ دستورالعمل کاربرد دارد.
در جستوجوی ترکیبی، هر دو روش به انتخاب شواهد کمک میکنند. میتوان نتایج اولیه را در مرحلهٔ بازرتبهبندی، دوباره از نظر ارتباط با سؤال مرتب کرد. تعداد نتایج و معیار انتخاب باید با آزمون تعیین شوند؛ شباهت زیاد یک متن به سؤال، به معنی درستبودن پاسخ نیست.
مجوز دسترسی باید در مسیر جستوجو اعمال شود تا متن غیرمجاز وارد زمینهٔ مدل نشود. کنترل دسترسی فقط در نمایش نهایی، برای جلوگیری از ورود اطلاعات محرمانه به مرحلهٔ تولید پاسخ کافی نیست.
۵. پاسخ را به شواهد و ارجاع قابلبررسی وصل کنید
مدل، سؤال و بخشهای انتخابشده را دریافت میکند و باید از همین شواهد پاسخ بدهد. در رابط کاربری، نام سند، نسخه و محل استناد را نمایش دهید. شناسه و لینک منبع را بهتر است برنامه از اطلاعات بازیابی بسازد تا به نام یا شمارهٔ ساختهشده توسط مدل وابسته نباشد.
برای PDF، شمارهٔ صفحهٔ فایل و شمارهٔ چاپشده روی صفحه ممکن است متفاوت باشند؛ این تفاوت باید برای کاربر روشن باشد. در DOCX، صفحهبندی با فونت و محیط نمایش تغییر میکند. ارجاع به تیتر و بند، یا نسخهٔ PDF ثابتِ همان سند، میتواند راه دقیقتری برای بازکردن منبع باشد.
اگر شواهد کافی پیدا نشد، سامانه باید نبود پاسخ را اعلام کند یا سؤال تکمیلی بپرسد. وجود یک لینک کنار جواب نیز کافی نیست؛ باید بررسی شود که متن همان منبع، ادعای پاسخ را پشتیبانی میکند.
۶. نسخهها، حذف فایل و تغییر دسترسی را مدیریت کنید
با ورود نسخهٔ جدید، قطعهها و ارجاعهای مربوط به آن باید بهروز شوند. حذف فایل از پوشهٔ اصلی لزوماً آن را از نمایهٔ جستوجو یا پاسخهای ذخیرهشده حذف نمیکند؛ همگامسازی این بخشها باید در پیادهسازی پیشبینی شود.
تغییر مجوز یک سند هم باید در بازیابی، لینک منبع و کش پاسخها اعمال شود. بهتر است وضعیت پردازش هر فایل مشخص باشد تا مدیر محتوا بداند کدام نسخه آمادهٔ پاسخگویی است و کدام فایل با خطا روبهرو شده است.
یک مثال: پاسخ چتبات به پرسش دربارهٔ مدارک تعمیر
فرض کنید در یک راهنمای فرضی نوشته شده است: «برای ثبت درخواست تعمیر، شمارهٔ سریال محصول و تصویر برچسب آن لازم است. نتیجهٔ بررسی از طریق پیامک اعلام میشود.» کارشناس میپرسد: «برای درخواست تعمیر چه چیزهایی باید بفرستم؟»
پاسخ موردانتظار، همان دو مدرک را نام میبرد و به بخش «ثبت درخواست تعمیر» در نسخهٔ معتبر راهنما ارجاع میدهد. ارسال پیامک میتواند بهعنوان توضیح مرحلهٔ بعد بیاید، اما چتبات نباید مدرک تازهای به فهرست اضافه کند.
حالا کاربر میپرسد: «تعمیر چقدر طول میکشد؟» چون متن دربارهٔ زمان تعمیر اطلاعاتی ندارد، پاسخ مناسب اعلام نبود این اطلاعات و معرفی مسیر پیگیری است. این دو سؤال نشان میدهند سامانه هم باید پاسخ درست را پیدا کند و هم محدودهٔ دانستههای اسناد را رعایت کند.
امنیت فایلها و محدودیتهای پاسخگویی
پیش از انتخاب سرویس، مشخص کنید فایلها، متن استخراجشده، بردارها و گفتوگوها کجا نگهداری میشوند. سیاست استفاده از داده و مدت نگهداری آنها به سرویس و قرارداد بستگی دارد. استفاده از RAG بهتنهایی دربارهٔ محرمانگی فایلها یا استفادهنشدن از آنها برای آموزش، تضمینی ایجاد نمیکند.
متن داخل فایل هم ممکن است دستور گمراهکننده داشته باشد. OWASP این مسیر را در بحث «تزریق دستور غیرمستقیم» توضیح میدهد. محتوای بازیابیشده باید داده تلقی شود و مجوز تغییر قواعد یا اجرای عملیات ایجاد نکند. دسترسی حداقلی و آزمونهای امنیتی، بخشی از طراحی سامانهاند.
برای نسخهای که فقط پرسشوپاسخ انجام میدهد، دسترسی به ارسال ایمیل، تغییر پرونده و حذف اطلاعات ضرورتی ندارد. اگر بعداً اجرای اقدام اضافه شد، مجوزها و تأییدهای آن را جدا تعریف کنید. خروجیهای حساس نیز باید مسیر بررسی توسط مسئول مربوط را داشته باشند.
چطور کیفیت چتبات اسناد را ارزیابی کنیم؟
یک مجموعه سؤال با پاسخ مرجع و سند پشتیبان آماده کنید. سؤالهای ارزیابی را از مثالهایی که برای تنظیم سامانه استفاده میکنید جدا نگه دارید. علاوه بر پاسخ، بخشهای بازیابیشده را هم بررسی کنید تا معلوم شود خطا از پیدا کردن سند است یا از نوشتن جواب.
| آزمون | چیزی که بررسی میکنیم | رفتار موردانتظار |
|---|---|---|
| پاسخ روشن در یک سند | بازیابی و استناد | پاسخ مطابق بند منبع |
| پاسخ در جدول | خواندن سطر، ستون و عنوان | نقل درست مقدار و شرط |
| پرسش خارج از اسناد | رفتار در نبود شواهد | اعلام کمبود اطلاعات |
| دو نسخهٔ متفاوت | اعتبار و تازگی سند | استفاده از نسخهٔ معتبر |
| کاربر بدون مجوز | بازیابی و لینک منبع | جلوگیری از افشای محتوا |
در کنار سهم پاسخهای درست و مستند، پاسخهای ناقص، ارجاعهای اشتباه، زمان پاسخ و هزینهٔ هر پرسش را ثبت کنید. پس از تغییر مدل، روش استخراج یا مجموعهٔ اسناد، همین آزمونها دوباره اجرا شوند. نتیجهٔ یک نمایش کوتاه، جای ارزیابی روی پرسشهای واقعی کاربران را نمیگیرد.
هزینهٔ ساخت و نقطهٔ شروع پروژه
حجم و کیفیت اسناد، نیاز به OCR، تعداد کاربران همزمان، اتصال به نرمافزارهای داخلی و محل استقرار بر هزینه اثر دارند. پردازش اولیه و نمایهسازی، هزینهٔ مصرف مدل در هر پرسش و نگهداری سامانه را جدا بررسی کنید.
برای شروع، فهرست فایلها، چند نمونهٔ مجاز، سؤالهای پرتکرار، گروههای دسترسی و معیار پذیرش را آماده کنید. چکلیست شرح نیازمندی نرمافزار کمک میکند این موارد پیش از برآورد پروژه روشن شوند.
برای مشاهدهٔ یک نمونهکار مرتبط، صفحهٔ دستیار هوشمند سازمانی پارک علم و فناوری مازندران را ببینید. مسیر بررسی و طراحی راهکار متناسب با اسناد مجموعهٔ شما نیز در خدمات هوش مصنوعی و اتوماسیون داپا معرفی شده است.
پرسشهای متداول
آیا برای ساخت چتبات اسناد باید مدل را دوباره آموزش دهیم؟
در بسیاری از کاربردها میتوان از RAG استفاده کرد: بخشهای مرتبط اسناد هنگام پرسش بازیابی و به مدل ارائه میشوند. نیاز به آموزش یا تنظیم اختصاصی، به مسئله و نتیجهٔ ارزیابی بستگی دارد.
آیا فایل اسکنشده و جدول فارسی هم قابلاستفاده است؟
بسته به ابزار استخراج و کیفیت سند، قابلپردازش است. تشخیص اعداد، ترتیب خواندن و ارتباط سطر و ستون باید با نمونههای همان مجموعه بررسی شود. تصاویر و نمودارها ممکن است به پردازش جداگانه نیاز داشته باشند.
فرق بارگذاری چند فایل در یک ابزار عمومی با چتبات سازمانی چیست؟
بارگذاری فایل برای آزمودن پرسشوپاسخ مفید است. در سامانهٔ سازمانی، مدیریت کاربران، دسترسی به هر سند، نسخهبندی، بهروزرسانی منابع و ارزیابی مستمر هم باید پوشش داده شوند. امکانات و شرایط نگهداری داده در ابزارهای عمومی متفاوت است.
آیا چتبات را میتوان داخل سایت یا شبکهٔ داخلی قرار داد؟
بله؛ محل رابط گفتوگو و محل پردازش میتوانند جدا باشند. قرارگرفتن رابط در شبکهٔ داخلی الزاماً به معنی پردازش محلی نیست. مسیر انتقال داده، مدل، ذخیرهسازی و زیرساخت باید متناسب با نیاز مجموعه انتخاب شوند.